यह टूल मुफ़्त है और आपके टेक्स्ट में छिपे Unicode कैरेक्टर को पहचानने और हटाने में मदद करता है। ChatGPT जैसे AI मॉडल Em-Dash या Zero Width Space जैसे छिपे हुए कैरेक्टर चुपके से जोड़ सकते हैं। यह टूल आपको उन्हें खोजने और अनावश्यक कैरेक्टर हटाने की सुविधा देता है।
हमारा मुफ़्त टूल छिपे हुए Unicode टेक्स्ट कैरेक्टर खोजता और हटाता है:
यह टूल आपके टेक्स्ट में छिपे Unicode कैरेक्टर दिखाता है और उन्हें हटाने की सुविधा देता है—आप विशिष्ट कोड चुन सकते हैं या सभी को एक साथ हटा सकते हैं।
टूल का इस्तेमाल करने के लिए:
1. अपना टेक्स्ट पेस्ट करें।
2. छिपे हुए Unicode कैरेक्टर देखें और उनके कार्यों के बारे में जानें।
3. चुनें कि क्या साफ़ करना है।
– सब कुछ ठीक करें।
– सभी अदृश्य कैरेक्टर हटाएँ।
– विशिष्ट कैरेक्टर चुनें (जैसे, Em-Dash, En-Dash)।
4. साफ़ किया हुआ टेक्स्ट कॉपी करें।
कृपया ध्यान रखें कि अगर कोई टेक्स्ट ChatGPT, Claude या Gemini जैसे लैंग्वेज मॉडल से बनाया गया है, तो Originality.ai के AI Detector से जाँच करने पर उसे अब भी AI-जनित के रूप में चिह्नित किया जा सकता है।
मुख्य बातें:
– आसान सफ़ाई – हमारा मुफ़्त टूल छिपे हुए टेक्स्ट कैरेक्टर को तुरंत खोजने और मिटाने में मदद करता है।
– निजता सुरक्षित – सब कुछ आपके ब्राउज़र में प्रोसेस होता है, इसलिए आपका टेक्स्ट आपके डिवाइस पर ही रहता है।
– वॉटरमार्क नहीं – छिपे हुए कैरेक्टर ChatGPT जैसे LLMs द्वारा जोड़े जाते हैं, लेकिन गुप्त निशान के तौर पर नहीं।
– कैरेक्टर का अत्यधिक उपयोग – ChatGPT अक्सर कई Unicode छिपे हुए कैरेक्टर इस्तेमाल करता है, जैसे Em Dash।
– वास्तविक जोखिम – अदृश्य टेक्स्ट सुरक्षा और फ़ॉर्मैटिंग से जुड़ी समस्याएँ पैदा कर सकता है।
– डिटेक्टर काम करते हैं – छिपे हुए कैरेक्टर हटाने के बाद भी AI Detection प्रभावी रहती है।
सभी LLMs में छिपे हुए कैरेक्टर शामिल होते हैं।
Unicode के छिपे हुए टेक्स्ट कैरेक्टर क्या हैं?
Unicode के छिपे हुए कैरेक्टर ऐसे विशिष्ट कोड पॉइंट होते हैं, जो साधारण ASCII से अलग होते हैं। कुछ कैरेक्टर हल्के तौर पर दिखाई देते हैं, जैसे em-dash और स्मार्ट कोट्स। वहीं zero-width spaces और joiners जैसे अन्य कैरेक्टर पूरी तरह अदृश्य होते हैं। ये कैरेक्टर “डिजिटल स्याही” की तरह काम करते हैं और सॉफ़्टवेयर द्वारा लाइनों को रैप करने, शब्दों को विभाजित करने या टेक्स्ट का मिलान करने के तरीके को बदल देते हैं—अक्सर आपको इसका पता भी नहीं चलता।
क्या ChatGPT अपने टेक्स्ट में वॉटरमार्क छिपाता है?
नहीं, यह एक गलतफ़हमी है। कुछ लोगों का मानना है कि ChatGPT अपने टेक्स्ट में छिपे हुए निशान जोड़ता है, लेकिन यह सच नहीं है। इसके बहुत असंभव होने के दो कारण हैं।
1. ऐसे निशानों को हटाना आसान है। अगर उपयोगकर्ता इन्हें आसानी से हटा सकते हैं, तो इनका इस्तेमाल करने का कोई मतलब नहीं बनता।
2. OpenAI का कहना है कि यह बड़े पैमाने पर reinforcement learning के काम करने के तरीके का नतीजा है।
क्या ChatGPT छिपे हुए कैरेक्टर जोड़ता है?
हाँ, ChatGPT जैसे AI मॉडल छिपे हुए कैरेक्टर जोड़ते हैं। इनमें से कई हानिरहित होते हैं, जैसे em-dash जैसे फ़ॉर्मैटिंग मार्क, लेकिन कुछ, जैसे zero-width spaces, फ़ॉर्मैटिंग बिगाड़ सकते हैं।
ChatGPT अक्सर कुछ सामान्य Unicode कैरेक्टर इस्तेमाल करता है:
Em Dash
यह लंबी डैश ChatGPT के टेक्स्ट में अक्सर दिखाई देती है—खासकर नए मॉडल (वर्ज़न o3, 4 o, 4.1) में—वाक्यों को अलग करने या नाटकीय ठहराव जोड़ने के लिए।
- Unicode: U+2014
- विवरण: यह हाइफ़न से चौड़ी एक लंबी, क्षैतिज डैश होती है। टाइपोग्राफ़ी में यह विराम के लिए उपयोगी है, लेकिन कोड, CSV या साधारण टेक्स्ट में यह एक गैर-मानक कैरेक्टर की तरह काम कर सकती है, जिससे कॉपी/पेस्ट या पार्सिंग में समस्याएँ आ सकती हैं।
- उदाहरण: word—word देखने में word-word जैसा लगता है, लेकिन यह एक अलग Unicode कोड पॉइंट है।
कर्ली कोट्स, जिन्हें टाइपोग्राफ़र कोट्स भी कहा जाता है, वे आकर्षक उद्धरण चिह्न होते हैं जो सामान्य सीधे उद्धरण चिह्नों की जगह दिखाई देते हैं। ChatGPT कभी-कभी इन कर्ली वर्ज़न का इस्तेमाल करता है।
Unicode में इनके विशिष्ट कोड होते हैं:
– बायाँ डबल कोट: U+201C
– दायाँ डबल कोट: U+201D
– बायाँ सिंगल कोट: U+2018
– दायाँ सिंगल कोट: U+2019
ये घुमावदार होते हैं और प्रिंटेड टेक्स्ट के लिए बनाए जाते हैं। ये उन जगहों पर दिखाई देते हैं जहाँ सीधे उद्धरण चिह्न (जैसे ” या ‘) बेहतर हो सकते हैं, जैसे कोडिंग, CSV फ़ाइलों या Markdown में। उदाहरण के लिए, आपको “hello” या ‘world’ दिखाई दे सकता है।
अदृश्य स्पेस
यह कैरेक्टर टेक्स्ट में छिपा रहता है और अक्सर ChatGPT जैसे कुछ एडिटर से कॉपी करते समय दिखाई देता है।
– Unicode: U+200B
– विवरण: यह कोई खाली जगह दिखाई नहीं देता, लेकिन कैरेक्टर को विभाजित कर देता है। इससे स्ट्रिंग मिलान, URLs और शब्दों की गिनती प्रभावित हो सकती है। इससे “यह सही तरीके से पेस्ट क्यों नहीं हो रहा?” जैसी समस्याएँ पैदा हो सकती हैं।
– उदाहरण: wordword ← यह एक ही शब्द जैसा लगता है, लेकिन इनके बीच एक अदृश्य स्पेस है।
LLMs छिपे हुए कैरेक्टर का इस्तेमाल क्यों करते हैं?
LLMs द्वारा इन अदृश्य कैरेक्टर का अधिक इस्तेमाल किए जाने के तीन कारण हैं:
1. प्रशिक्षण का झुकाव: LLMs पेशेवर रूप से संपादित टेक्स्ट से सीखते हैं। इन टेक्स्ट में अक्सर em-dash और स्मार्ट कोट्स होते हैं, इसलिए LLMs रोज़मर्रा की लेखन शैली की तुलना में इनका अधिक इस्तेमाल करते हैं।
2. औपचारिक शैली: LLMs का लहजा अक्सर औपचारिक या अधिकारपूर्ण होता है और ये कैरेक्टर उस शैली को बनाने में मदद करते हैं।
3. कीबोर्ड की सीमाएँ नहीं: हम इन कैरेक्टर का अक्सर इस्तेमाल नहीं करते, क्योंकि ये मानक कीबोर्ड पर उपलब्ध नहीं होते। LLMs कीबोर्ड पर टाइप नहीं करते, इसलिए उनके लिए छिपे हुए कैरेक्टर का इस्तेमाल करना आसान होता है।
अदृश्य कैरेक्टर: उपयोग और समस्याएँ
लोग इनका इस्तेमाल क्यों करते हैं?
1. व्यवस्थित टेक्स्ट व्यवस्था – zero-width space या soft hyphen लेखकों को यह तय करने में मदद करता है कि लाइन कहाँ टूटे, जिससे लंबे शब्द मार्जिन पर अटपटे ढंग से लटकने से बचते हैं।
2. यूज़रनेम में “स्पेस” – कुछ साइटें वास्तविक स्पेस की अनुमति नहीं देतीं। अदृश्य Hangul Filler का इस्तेमाल करके John Doe जैसे नाम “नो-स्पेस” नियम का पालन करते हुए भी पढ़ने योग्य बने रहते हैं।
3. छिपे हुए वॉटरमार्क – प्रकाशक किसी टेक्स्ट में zero-width marks का एक अनोखा पैटर्न जोड़ सकते हैं। अगर टेक्स्ट लीक हो जाए, तो ये अदृश्य बिंदु डिजिटल फिंगरप्रिंट की तरह काम करते हैं।
लोग इनके बारे में चिंतित क्यों होते हैं?
– फ़ॉर्मेटिंग: ये एक जैसे दिखते हैं, लेकिन अलग तरह से काम करते हैं। छिपे हुए वर्ण शामिल होने पर एक जैसे दिखने वाले दो हिस्सों का हैश या क्रम अलग हो सकता है, जिससे एक्सपोर्ट, खोज या ऑडिट ट्रेल प्रभावित हो सकते हैं।
– हानिकारक कोड छिपाने की अदृश्य जगहें: हमलावर ज़ीरो-विड्थ वर्णों के बीच मैलवेयर या गुप्त कमांड छिपा सकते हैं; फ़ाइल काम करती रहती है, लेकिन मानव कोड समीक्षक को कुछ भी असामान्य दिखाई नहीं देता।
– AI के साथ गुप्त चालें: छिपा हुआ Unicode चैटबॉट के प्रॉम्प्ट में अतिरिक्त कमांड डाल सकता है, जिससे मॉडल उपयोगकर्ता को पता चले बिना डेटा उजागर कर सकता है या हानिकारक सामग्री बना सकता है।
– आपका टेक्स्ट AI-जनरेटेड लगता है: अगर टेक्स्ट में AI द्वारा अक्सर इस्तेमाल की जाने वाली अनोखी फ़ॉर्मेटिंग (जैसे Em Dashes) बहुत अधिक हो, तो यह स्पष्ट हो जाता है कि उसे AI ने बनाया है, जिससे आपकी प्रतिष्ठा को नुकसान पहुँच सकता है।
क्या अदृश्य वर्ण जोड़ने या हटाने से AI डिटेक्टरों को चकमा देने में मदद मिलती है?
नहीं, ऐसा नहीं होता। हमारे त्वरित परीक्षण से पता चला कि छिपे हुए वर्ण जोड़ने या हटाने से AI द्वारा बनाए गए कंटेंट को पहचानना आसान या कठिन नहीं हुआ। हमने AI कंटेंट के दो नमूने बनाए और इस पेज पर उपलब्ध मुफ़्त टूल का इस्तेमाल करके अतिरिक्त छिपे हुए वर्ण जोड़कर और सभी Unicode वर्ण हटाकर उनमें बदलाव किए।
नतीजा यह रहा कि अदृश्य वर्ण चाहे जैसे भी हों, अधिकांश टूल्स कंटेंट का पता लगा सके।
यहाँ परिणाम दिए गए हैं…
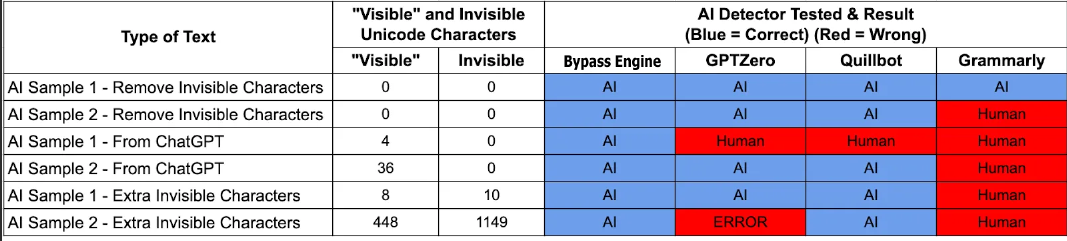
टेक्स्ट AI उदाहरण 2 – अतिरिक्त छिपे हुए वर्णों में कई गुप्त प्रतीक थे!
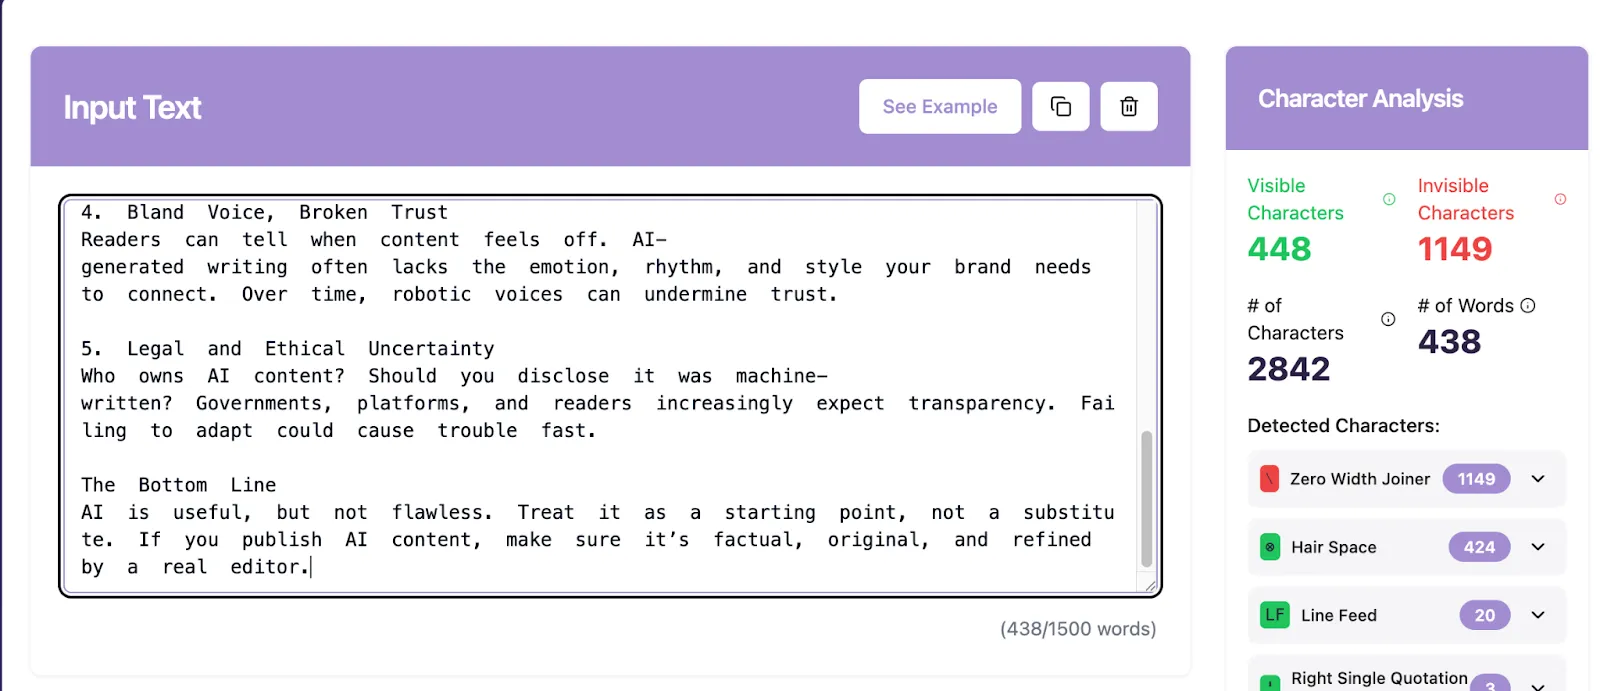
जब ChatGPT से जानबूझकर अतिरिक्त वर्ण शामिल करने को कहा गया, तो उसने सावधानी बरतने की चेतावनी दी…
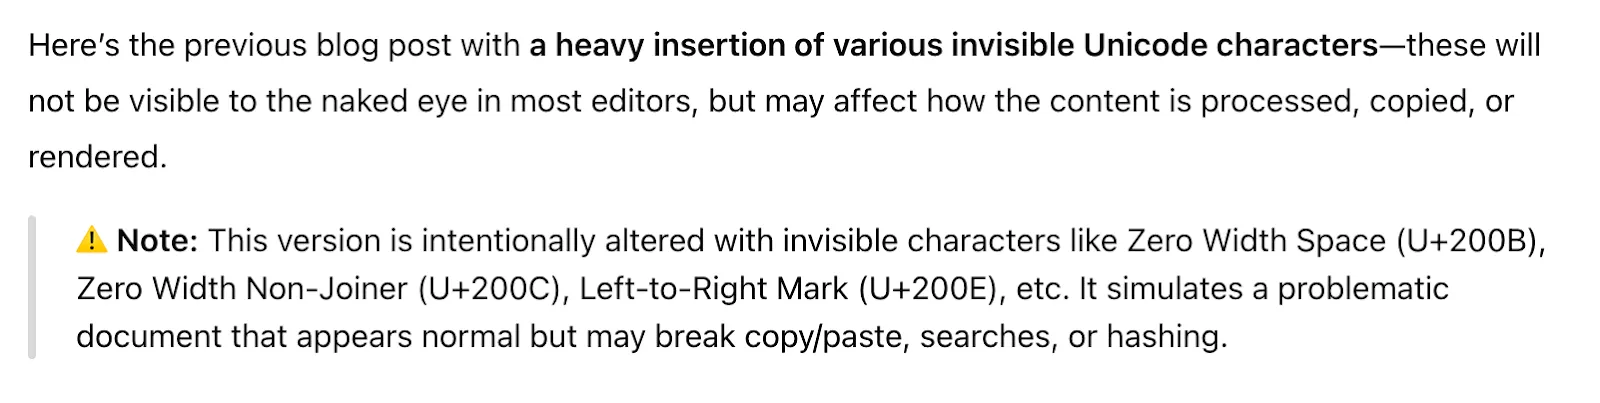
क्या सभी बड़े भाषा मॉडल छिपे हुए वर्ण चुपके से शामिल करते हैं?
हाँ, ऐसा होता है। हमने छिपे हुए वर्णों की जाँच करने के लिए अलग-अलग प्रसिद्ध LLM पर एक ही प्रॉम्प्ट का परीक्षण किया।
प्रॉम्प्ट: LinkedIn पोस्ट की फ़ॉर्मेटिंग के फ़ायदों पर प्रकाश डालते हुए एक LinkedIn पोस्ट का मसौदा तैयार करें।
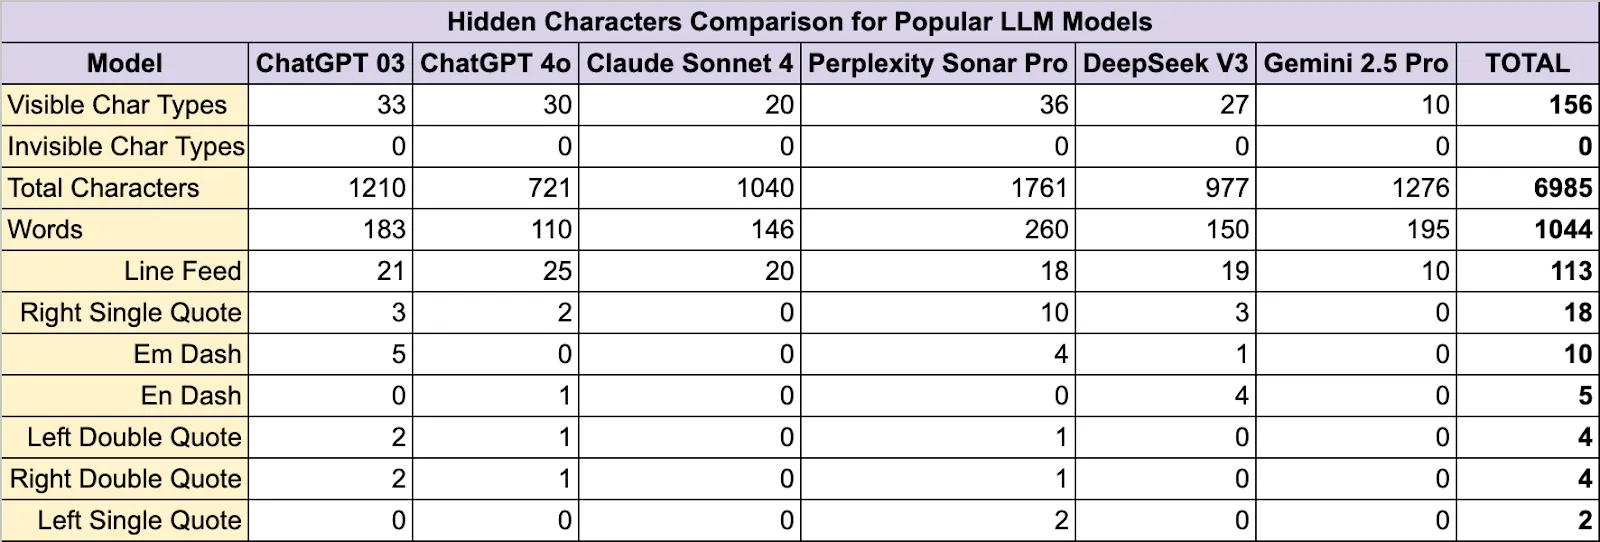
किसी भी मॉडल ने अदृश्य वर्ण नहीं बनाया, लेकिन सभी ने फ़ॉर्मेटिंग के लिए बहुत सारे दिखाई देने वाले Unicode वर्णों का इस्तेमाल किया।