Давайте разберёмся, что такое большие языковые модели и что они на самом деле означают. А также узнаем, как распознавание ИИ-контента помогает сохранять прозрачность по мере распространения материалов, созданных ИИ.
Многим сложно разобраться в сложных терминах, связанных с умными компьютерами. Сейчас они встречаются повсюду.
Но когда мы слышим такие выражения, как «технологии, которые умеют разговаривать», «обучающиеся машины», и «умный поиск», это звучит непривычно и непонятно.
Люди, интересующиеся ИИ, часто говорят о больших языковых моделях.
Сайты и приложения заявляют, что используют их, чтобы помогать нам, но не объясняют, что это такое. Поэтому в этой статье мы подробнее рассмотрим большие языковые модели, чтобы вы лучше поняли принцип работы умных компьютеров.
Нет времени? Коротко рассказываем главное:
1. Большие компьютерные программы, называемые большими языковыми моделями, собирают огромное количество информации. Они используют её, чтобы отвечать на вопросы людей.
2. ChatGPT — популярный пример таких масштабных программ, которыми пользуются многие.
3. В Bypass Engine есть отличный инструмент для распознавания контента, созданного ИИ. Он помогает сохранять прозрачность и честность в интернете.
Что такое большие языковые модели (LLM)?
Давайте разберёмся. Что такое большая языковая модель, или LLM?
Amazon Web Services называет их большими моделями глубокого обучения. Перед использованием они обучаются на огромных объёмах данных.
Они состоят из компонентов, которые называются энкодером и декодером.
Они помогают понимать тексты и связи между словами. Это может показаться сложным.
Вот простой пример.
Слова выглядят одинаково, поэтому языковым моделям нужны большие объёмы обучения и данных.
Это помогает им понимать, что именно вы имеете в виду, используя эти слова.
Например, если вы попросите ChatGPT: «назови 10 лучших мест, где можно найти бас»,
ему нужно определить, имеете ли вы в виду места для рыбалки или магазины музыкальных инструментов.
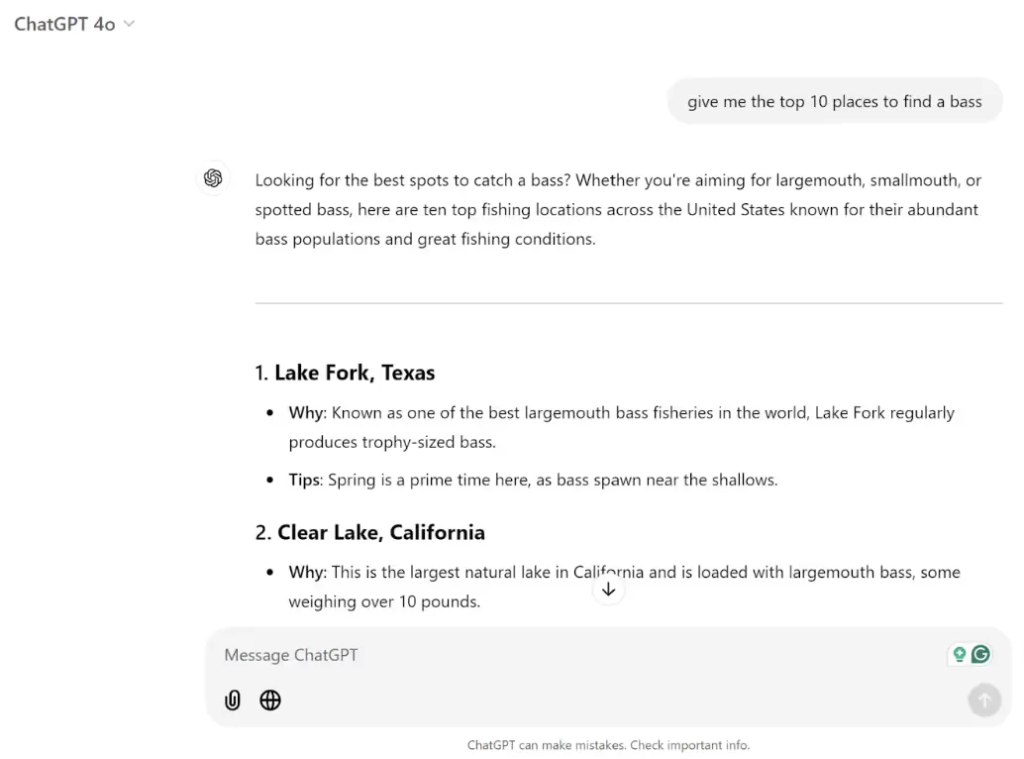
Конечно, этот пример немного утрирован, а другие примеры менее однозначны. Но он показывает, как работает этот процесс.
Большая языковая модель видит запрос, просматривает свою обширную базу данных и определяет, какой вопрос вы задаёте.
Является ли ChatGPT большой языковой моделью?
Да. Люди часто задают этот вопрос. ChatGPT хорошо известен как одна из таких моделей.
Он обучен на огромном объёме данных и отвечает на вопросы пользователей настолько хорошо, насколько может.
ChatGPT знает многое, но не всё.
Объём его знаний ограничен. Это связано с датой окончания обучения.
Поэтому ChatGPT может не знать последнюю информацию, поскольку ещё не успел ей обучиться.
Когда ChatGPT впервые появился, его знания охватывали период только до сентября 2021 года. Об этом сообщал институт Poynter.
Теперь новейшая версия, GPT-4, знает информацию вплоть до октября 2023 года. Об этом сообщила OpenAI.
Как распознать тексты, созданные ИИ
Многие спрашивают: как понять, помогал ли ИИ создавать текст?
Хотя некоторые считают, что могут распознать тексты, написанные ИИ, исследования показывают, что это сложно. Поэтому мы используем инструменты для выявления текстов, созданных ИИ.
Инструмент под названием Bypass Engine отлично справляется с поиском текстов, созданных ИИ.
Редакторы используют этот инструмент, чтобы поддерживать ясность своих статей.
Это помогает создателям контента, владельцам сайтов и редакторам.
Большие языковые модели: для чего они нужны?
Большие языковые модели, или LLM, требуют значительных усилий для обучения. Они созданы для того, чтобы понимать и писать тексты подобно людям. Вот простой обзор того, как подготавливают эти системы ИИ:
1. Сбор текстов: сначала мы собираем огромное количество текстов из книг, статей, сайтов и чатов. Эти данные должны быть разнообразными и охватывать разные темы, чтобы модель могла изучить множество языковых закономерностей и значений.
2. Подготовка данных: мы очищаем данные до того, как модель их увидит. Это включает удаление дубликатов, исправление ошибок и приведение текста к единому формату. Мы также удаляем конфиденциальный контент и материалы с предвзятыми взглядами, чтобы предотвратить вредные ответы модели.
3. Создание модели: большие языковые модели используют сети, которые называются трансформерами. Эти сети помогают модели понимать, как слова связаны друг с другом. Энкодеры и декодеры помогают модели воспринимать контекст и значение.
4. Обучение модели: увидев предыдущие слова, модель угадывает следующее. Она совершенствуется, повторяя этот процесс множество раз и корректируя себя, чтобы стать точнее. Для этого требуется большая вычислительная мощность.
5. Дообучение: после базового обучения модели адаптируют под конкретные задачи. Для этого используются специальные наборы данных — например, для чатов службы поддержки, составления кратких изложений юридических документов или консультаций по вопросам здоровья.
6. Мы тщательно проверяем модели. Нам важно, чтобы ответы имели смысл, соответствовали контексту и были правильными. При необходимости разработчики улучшают модель на основе полученных результатов.
7. После запуска моделей мы следим за их работой. Разработчики корректируют их, чтобы устранять проблемы, контролировать предвзятость и улучшать ответы на основе реального использования.
Языковые модели: не только чат-боты!
Мы часто слышим о чат-ботах на базе больших языковых моделей. Но эти системы ИИ умеют гораздо больше. Они меняют работу во многих сферах: выполняют задачи, помогают принимать решения и персонализируют взаимодействие. Давайте посмотрим, как они работают за пределами чатов:
Здравоохранение:
Помощь врачам: языковые модели анализируют симптомы и предлагают варианты лечения.
Быстрый поиск: учёные используют их, чтобы быстро составлять краткие обзоры медицинских исследований.
Финансы:
Служба поддержки клиентов: банки используют модели, чтобы помогать клиентам решать вопросы со счетами и транзакциями.
Выявление мошенничества: ИИ анализирует финансовые данные и обнаруживает необычную активность, которая может указывать на мошенничество.
Образование:
Обучение с учётом ваших потребностей: языковые модели создают образовательный маршрут, соответствующий темпу ученика.
Помощь учителям: ИИ помогает преподавателям создавать викторины, краткие изложения и планы уроков.
Право и соблюдение требований:
Проверка договоров: модели автоматизируют анализ договоров, выявляя ключевые положения и риски.
Всегда в курсе правовых изменений: компании используют ИИ, чтобы следить за изменениями в законодательстве и снижать риски несоблюдения требований.
Контент и медиа:
Автоматизированное создание текстов: авторы используют языковые модели для написания постов в блогах, публикаций в социальных сетях и сценариев.
Языковые волшебники: инструменты перевода на базе ИИ помогают людям по всему миру общаться на разных языках.
Обслуживание клиентов и клиентский опыт:
Помощь всегда под рукой: компании используют виртуальных помощников на базе ИИ для круглосуточной поддержки клиентов.
С учётом ваших предпочтений: платформы используют ИИ, чтобы улучшить пользовательский опыт с помощью персонализированных рекомендаций.
По мере совершенствования этих моделей расширяются и сферы их применения. Они меняют целые отрасли, упрощая выполнение задач, помогая принимать решения и стимулируя инновации.
Почему важно знать о LLM
Сегодня ИИ используется повсюду. Понимание принципов работы больших языковых моделей помогает эффективнее применять их на практике. Они умеют многое: от автоматизации задач до создания контента. Это открывает новые возможности для людей и бизнеса. Но у них есть и ограничения. Модели могут быть предвзятыми или использовать устаревшую информацию, поэтому важно проявлять осторожность. Понимание принципов работы LLM помогает эффективнее общаться с разработчиками и пользователями. Благодаря этому ИИ лучше соответствует реальным потребностям. Такие знания позволяют руководителям принимать взвешенные решения об использовании ИИ, развивать новые идеи и соблюдать этические нормы. Понимание основ также помогает выявлять ошибки в контенте, созданном ИИ, и способствует его ответственному и безопасному применению.
Часто задаваемые вопросы о больших языковых моделях
Могут ли большие системы ИИ давать правильные ответы?
Эффективность больших систем ИИ зависит от задачи, формулировки вопросов и данных, на которых они обучались. Важно помнить, что интеллектуальные системы ИИ могут выдумывать информацию: это происходит, когда ИИ принимает за правду то, что на самом деле ею не является. Поэтому крайне важно перепроверять их ответы.
Есть ли у больших систем ИИ предубеждения?
Да, большие системы ИИ обучаются на огромных объёмах информации, и если в этих данных присутствуют предубеждения, ИИ может их воспроизводить. Для разработчиков ИИ всё более важными становятся вопросы правильного и справедливого использования технологий.


